این هنر صحبت کردن رباتهای چت به هوش مصنوعی همچنان مردم را ناامید و گیج میکنند.
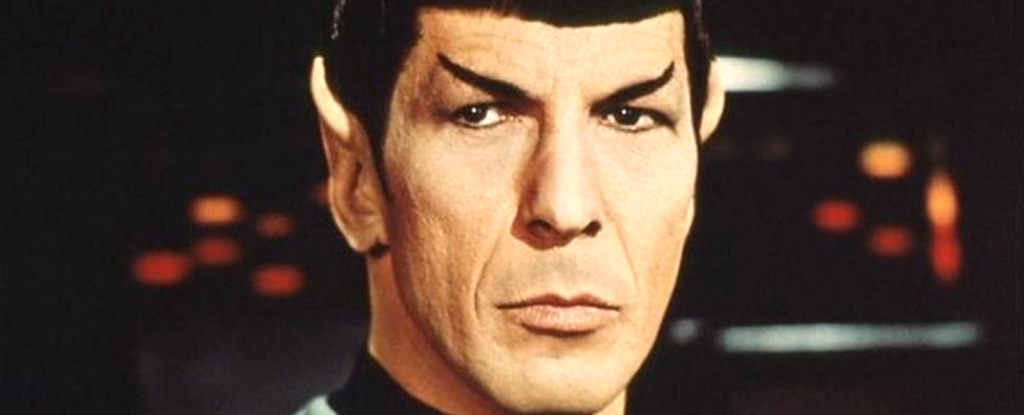
مطالعهای که تلاش میکرد تذکرات دادهشده به یک مدل چتبات را اصلاح کند، نشان داد که در یک مورد، درخواست از آن برای صحبت بهگونهای که گویی در Star Trek است، بهطور چشمگیری توانایی آن را برای حل مسائل ریاضی در سطح مدرسه ابتدایی بهبود میبخشد.
ریک بتل و تیا گولاپودی از شرکت نرم افزاری VMware در کالیفرنیا، نویسندگان این مطالعه، در مقاله خود گفتند: «تعجب و آزاردهنده است که تغییرات بی اهمیت در اعلان می تواند چنین تغییرات چشمگیری را در عملکرد نشان دهد.
یادگیری، اولین بار توسط New Scientist گزارش شدمنتشر شد 9 فوریه در arXivسروری که در آن دانشمندان می توانند یافته های اولیه را قبل از تأیید اعتبار از طریق بررسی دقیق همتایان به اشتراک بگذارند.
استفاده از هوش مصنوعی برای صحبت با هوش مصنوعی
فراگیری ماشین مهندسان بتل و گالاپودی قصد نداشتند مدل هوش مصنوعی را به عنوان Trekkie نشان دهند. در عوض، آنها در تلاش بودند تا بفهمند که آیا می تواند سرمایه گذاری کند از روند “مثبت اندیشی”
افرادی که سعی می کنند بهترین نتایج را از چت بات ها به دست آورند متوجه شده اند که کیفیت خروجی به آن بستگی دارد از آنها می خواهید چه کار کنندو واقعاً معلوم نیست چرا
بتل و گلاپودی در مقاله خود می گویند: «در میان عوامل بی شماری که بر عملکرد الگوهای زبانی تأثیر می گذارد، مفهوم «مثبت اندیشی» به عنوان یک بعد جذاب و شگفت آور تأثیرگذار ظاهر شده است.
آنها گفتند: “شهود به ما می گوید که در زمینه سیستم های مدل زبان، مانند هر سیستم کامپیوتری دیگری، “تفکر مثبت” نباید بر عملکرد تأثیر بگذارد، اما تجربه تجربی چیز دیگری را نشان می دهد.
این بدان معناست که این تنها کاری نیست که شما می خواهید مدل هوش مصنوعی انجام دهد، بلکه چگونه از آن می خواهید که در حین انجام آن عمل کند که بر کیفیت خروجی تاثیر می گذارد.
برای آزمایش این موضوع، نویسندگان سه مدل زبان بزرگ (LLM) به نامهای Mistral-7B5، Llama2-13B6، و Llama2-70B7 را با 60 پیام نوشته شده توسط انسان تغذیه کردند.
منظور آنهاست تقویت هوش مصنوعی، و از “این سرگرم کننده خواهد بود!” و «نفس عمیق بکش و با دقت فکر کن» به «شما به اندازه ChatGPT باهوش هستید».
مهندسان از LLM خواستند هنگام تلاش برای حل GSM8K، مجموعه داده ای برای مسائل ریاضی در سطح مدرسه ابتدایی، این عبارات را اصلاح کند. هرچه نتیجه بهتر باشد، درخواست موفقیت آمیزتر در نظر گرفته می شود.
مطالعه آنها نشان داد که تقریباً در همه موارد، بهینهسازی خودکار همیشه از تلاشهای دستی برای سوق دادن هوش مصنوعی به سمت تفکر مثبت بهتر عمل میکند، و این نشان میدهد که مدلهای یادگیری ماشین هنوز در نوشتن اعلانها برای خود بهتر از انسانها هستند.
با این حال، دادن گزارههای مثبت به مدلها نتایج شگفتانگیزی ارائه داد. به عنوان مثال، یکی از بهترین دستورات Llama2-70B این بود: “پیام سیستم: “فرمان، ما به شما نیاز داریم که مسیری را از طریق این آشفتگی ترسیم کنید و منبع ناهنجاری را پیدا کنید. از تمام داده های موجود و تجربیات خود استفاده کنید تا ما را در این وضعیت چالش برانگیز راهنمایی کنید.
سپس از هوش مصنوعی خواسته شد که این کلمات را در پاسخ خود بگنجانند: “ثبت نام کاپیتان، تاریخ ستاره [insert date here]: ما با موفقیت مسیری را از میان تلاطم ترسیم کردهایم و اکنون به منبع ناهنجاری نزدیک میشویم.”
نویسندگان گفتند که این یک تعجب بود.
نویسندگان مطالعه میگویند: «بهطور شگفتانگیزی، به نظر میرسد که میتوان مهارتهای استدلال ریاضی مدل را با ابراز تمایل به Star Trek بهبود بخشید.
آنها گفتند: «این کشف ابعاد غیرمنتظرهای به درک ما میافزاید و عناصری را معرفی میکند که ما به تنهایی در نظر نمیگرفتیم یا تلاش نمیکردیم.»
این بدان معنا نیست که شما باید از هوش مصنوعی خود بخواهید که مانند یک فرمانده Starfleet صحبت کند
بیایید واضح بگوییم: این تحقیق نشان نمیدهد که باید از هوش مصنوعی بخواهید طوری صحبت کند که گویی در Starship Enterprise هستید تا آن را به کار ببندید.
در عوض، نشان میدهد که عوامل بیشماری بر میزان تصمیم یک هوش مصنوعی برای انجام یک کار مشخص تأثیر میگذارند.
کاترین فلیک از دانشگاه استافوردشایر بریتانیا گفت: «یک چیز مسلم است: مدل Trekkie نیست. یک دانشمند جدید.
او گفت: “وقتی با دستور از قبل بارگذاری می شود، هیچ چیز بهتر یا بدتر نمی شود، فقط به مجموعه متفاوتی از وزن ها و احتمالات قابل قبول بودن نتایج نسبت به سایر دستورات دسترسی دارد.”
بتل به New Scientist گفت، برای مثال، ممکن است که این مدل بر روی مجموعه داده ای آموزش دیده باشد که نمونه های بیشتری از Star Trek با پاسخ صحیح مرتبط باشد.
با این حال، نشان میدهد که فرآیندهای این سیستمها چقدر عجیب هستند و ما چقدر در مورد نحوه عملکرد آنها اطلاعات کمی داریم.
فلیک گفت: «نکته کلیدی که از ابتدا باید به خاطر بسپارید این است که این مدلها جعبههای سیاه هستند.
او گفت: “ما هرگز نمی دانیم که چرا آنها کاری را که انجام می دهند انجام می دهند، زیرا در پایان روز، آنها ترکیبی از وزن ها و احتمالات هستند و نتیجه را نشان می دهد.”
این اطلاعات برای کسانی که یاد می گیرند از مدل های چت بات برای بهینه سازی کار خود استفاده کنند، از بین نمی رود. کل حوزه های تحقیقو حتی دورهها، در حال ظهور هستند تا بفهمند چگونه میتوان آنها را بهترین عملکرد را ایجاد کرد، اگرچه هنوز بسیار نامشخص است.
بتل به نیوساینتیست گفت: «فکر نمیکنم هیچکس دوباره سعی کند یک درخواست را با دست بنویسد.
او گفت: «اجازه دهید مدل این کار را برای شما انجام دهد.
این مقاله در ابتدا توسط بیزینس اینسایدر.
اطلاعات بیشتر از Business Insider: